Le test qui échouait n'était jamais celui qui avait le bug
Un teardown ne s'exécute pas quand le processus meurt. Les tests suivants tombent alors en cascade, très loin du coupable. Ce qu'on peut ajouter pour combler ce trou.
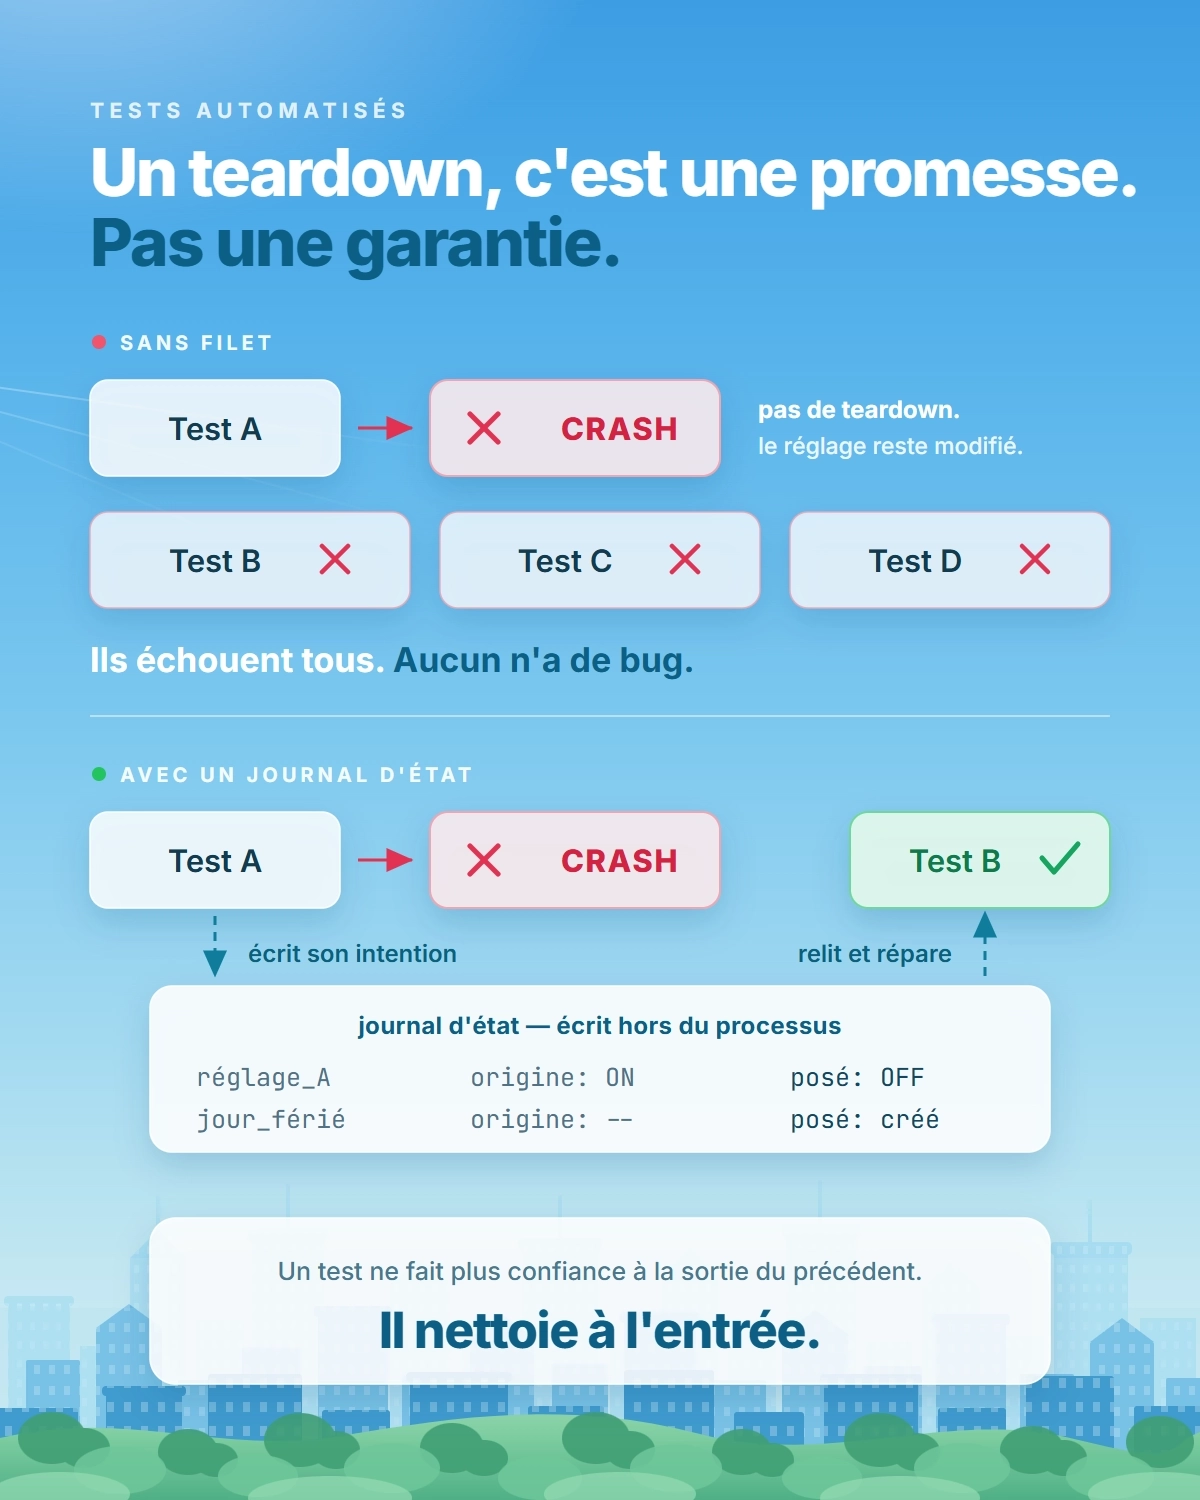
Sur une application mobile métier, certains tests modifient des réglages globaux : une option de facturation, une grille tarifaire, un jour férié. Le teardown remet tout en place.
Sur le papier.
Des réglages qu’on emprunte, jamais qu’on possède
Un principe de base veut que chaque test soit maître de ses données. Il crée ce dont il a besoin, il le nettoie, il n’interfère avec personne. Le principe est bon, et je l’applique.
Mais il ne couvre pas tout. Certains réglages sont globaux par nature : les tests ne peuvent que se les partager. Ils ne les possèdent pas, ils les empruntent.
L’exemple est trivial à décrire. Un paramètre vaut 15 par défaut. Mon test a besoin qu’il vaille 10. Si la restauration ne passe pas, il reste à 10, et le test suivant, qui attend 15, tombe.
Un teardown est une promesse, pas une garantie
Il ne s’exécute pas quand l’application plante. Ni quand la session mobile meurt. Ni quand quelqu’un arrête le run en cours. Dans ces trois cas, le réglage reste modifié, et la suite continue de tourner dans un monde que plus personne ne décrit.
Ce n’est pas un défaut d’implémentation qu’on corrigerait en écrivant un meilleur teardown. C’est structurel : le teardown vit dans le processus qu’il est censé rattraper. Quand ce processus disparaît, il disparaît avec lui. On peut l’entourer de gestionnaires d’erreurs, de tentatives, de délais de grâce, on ne change rien au cas qui compte vraiment, celui où il n’y a plus personne pour exécuter quoi que ce soit.
Le coût réel n’est pas l’état cassé, c’est la distance
Un réglage global modifié ne fait pas échouer le test suivant. Il fait échouer certains tests suivants, parfois des dizaines plus loin, parfois seulement ceux qui traversent l’écran concerné.
Le rapport affiche alors une grappe d’échecs qui n’ont rien en commun, aucun ne correspondant à une régression du produit. Le vrai coupable, lui, est passé au vert : il a fait son travail, il a même parfois détecté le bug qu’on lui demandait de détecter. Il a juste laissé la pièce en désordre avant de mourir.
Diagnostiquer cette situation demande de remonter la chronologie complète du run, d’identifier quel test a touché quoi, et de reconstituer l’état à chaque étape. C’est long, et c’est à refaire à chaque fois. Le symptôme le plus courant, dans une équipe, c’est la phrase « relance, ça passera ».
Une seconde ligne de défense
J’ai arrêté de chercher à rendre le teardown infaillible. Pas de l’utiliser : il reste en place, et c’est lui qui restaure dans la quasi-totalité des exécutions. Sous Robot Framework, il s’exécute d’ailleurs quel que soit le verdict du test, comme il doit. Ce qu’il ne sait pas faire, c’est survivre à la mort du processus.
Le changement n’est donc pas un remplacement, c’est un ajout : une vérification supplémentaire à l’entrée. Un test ne suppose plus que la place est propre, il s’en assure avant de commencer.
Écrire son intention avant d’agir
Avant de toucher un réglage sensible, le test inscrit ce qu’il s’apprête à faire dans un journal d’état, écrit hors du processus :
- quel paramètre ;
- sa valeur d’origine ;
- la valeur qu’il pose.
L’ordre compte. L’écriture précède la modification, jamais l’inverse. Si le programme meurt entre les deux, le pire scénario est une entrée qui décrit une modification qui n’a pas eu lieu, et la réparation sera sans effet. L’ordre inverse produirait le cas dangereux : une modification réelle dont plus rien ne garde la trace.
Le mot important est hors du processus. Une variable, une liste en mémoire, un attribut de classe : tout cela meurt avec le programme, exactement au moment où l’information devient nécessaire. Un fichier survit au plantage, à l’arrêt manuel, et même au redémarrage de la machine.
Réparer à l’entrée, comme un utilisateur
Le teardown, quand il s’exécute, restaure la valeur et marque l’entrée soldée. C’est le cas nominal, et il couvre la grande majorité des exécutions.
Le reste tient dans une seule règle : chaque setup relit le journal et répare ce qui traîne. Si une entrée non soldée est là, c’est qu’un run précédent est mort en cours de route. Le test remet la valeur d’origine avant de commencer son propre travail.
Et il la remet en passant par la vraie interface, comme le ferait un utilisateur. C’est un choix, pas une facilité. Écrire directement en base irait plus vite, mais contournerait tout ce que l’application fait au moment d’un changement de réglage : les contrôles, les recalculs, les mises en cache, les effets de bord. On réparerait la valeur sans réparer l’état, et on se retrouverait avec une incohérence plus difficile à voir que celle qu’on corrigeait.
La conséquence est franche à énoncer :
Un test ne fait plus confiance à la sortie du test précédent. Il nettoie à l’entrée.
« Il suffirait d’isoler »
L’objection vient toujours, et elle est légitime : si chaque exécution avait son propre compte, le problème disparaîtrait.
La parallélisation est effectivement réglée ainsi, un compte par exécution. Mais cela ne traite pas le partage à l’intérieur d’une même exécution : dès que deux tests se succèdent sur le même compte, le second retrouve le paramètre que le premier n’a pas restauré. L’isolation par compte déplace la frontière, elle ne la supprime pas.
Il faudrait donc un compte par test. C’est jouable quand très peu de tests touchent à ces paramètres et qu’on vérifie, à chaque ajout, qu’ils ne se marchent pas dessus. Cette vérification-là est à refaire indéfiniment, et elle repose sur la vigilance de celui qui écrit le test.
Même dans ce cas, un journal d’état ne coûte rien et ne peut pas nuire.
Ce qui peut mal tourner
Peu de choses, et c’est ce qui rend le dispositif intéressant : une fois en place, il demande très peu d’entretien.
Le seul incident que j’ai eu ne venait pas du mécanisme mais de mon propre code. L’ajout d’un paramètre critique d’une nature un peu particulière a demandé d’adapter les mots-clés qui gèrent le journal. Une erreur s’y est glissée, et l’un des paramètres a cessé d’être mis à jour.
La leçon n’est pas très originale, mais elle mérite d’être dite : un journal d’état est de l’infrastructure de test, et l’infrastructure de test se régresse comme le reste. Elle mérite donc ses propres vérifications.
Ce que je retiens
Le teardown reste indispensable. C’est lui qui restaure dès que le test arrive au bout, c’est-à-dire presque toujours, et rien ne le remplace dans ce rôle. Ce qu’il ne peut pas faire, par construction, c’est couvrir les cas où le processus meurt avant lui.
Le journal d’état ne prend pas sa place : il ferme ce trou-là. Et il le ferme avec une garantie d’une autre nature, qui ne dépend plus du bon déroulement de ce qui précède, mais seulement de la capacité du test suivant à lire un fichier avant de commencer.
Un fichier, ça survit.