70 % du temps de mes tests ne testait rien
Sur une suite de tests mobiles, la mise en condition consommait sept dixièmes du temps d'exécution. Comment la déplacer vers l'API, et surtout quand ne pas le faire.
Les tests automatisés sur application native, c’est lent. Et on veut valider les livraisons vite.
Alors quand une suite atteint quelques centaines de tests, un objectif s’installe en permanence : réduire le temps d’exécution. On commence par les suspects habituels. Paralléliser. Supprimer les attentes fixes. Découper par tags.
J’ai fait tout ça. Puis j’ai mesuré où partait réellement le temps, et la réponse n’était dans aucune de ces trois cases.
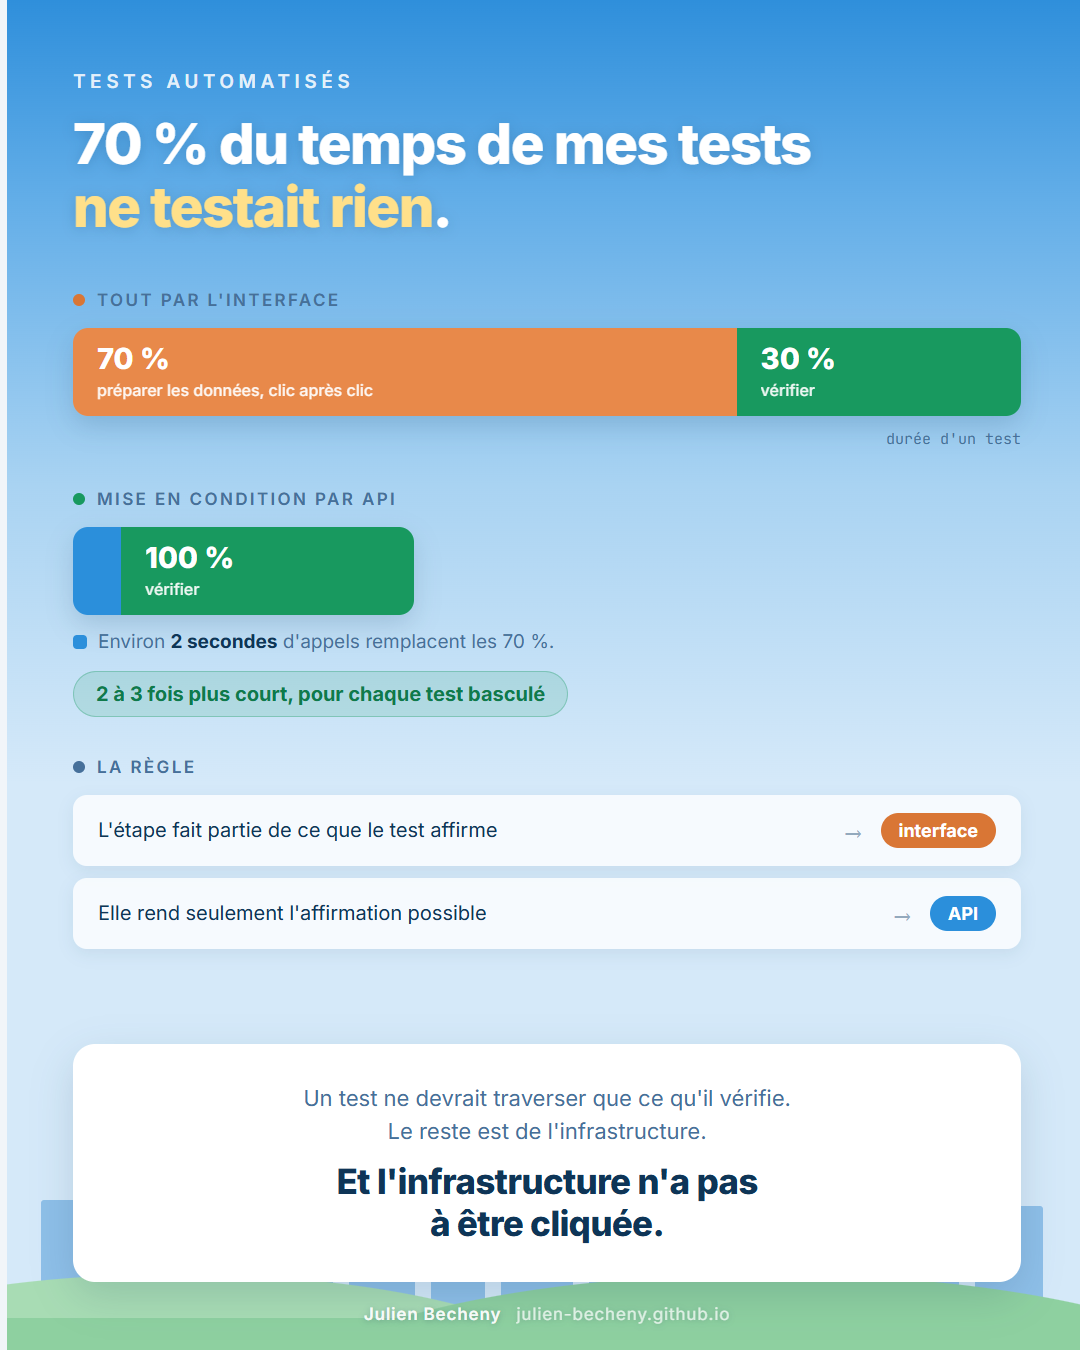
Sept dixièmes du temps d’exécution étaient consommés par la préparation des données, clic après clic dans l’interface. La vérification, celle pour laquelle le test existe, tenait dans les trois dixièmes restants.
Mesurer avant de décider
Ce chiffre n’était pas une impression. C’est le point important, et c’est d’ailleurs le seul travail qui n’est pas optionnel dans toute cette histoire.
Un test qui crée un dossier, saisit une fiche, valide un formulaire puis vérifie qu’un montant s’affiche correctement passe l’essentiel de son temps dans les trois premières étapes. Aucune d’elles n’est le sujet du test. Elles sont la condition pour que le sujet existe.
Tant qu’on ne sépare pas ces deux natures dans la mesure, on optimise à l’aveugle. On gagne trois secondes sur une attente pendant que quarante secondes partent dans une saisie de formulaire qui ne fait pas l’objet du test.
Le setup par l’interface coûte deux fois
Le coût évident, c’est le temps. Il y en a un second, moins visible et plus cher.
Chaque écran traversé pour préparer une donnée est une occasion de casser. Un libellé qui change, un champ qui se décale, une popup de mise à jour qui s’intercale, une lenteur réseau sur un écran intermédiaire. Le test échoue, et il échoue dans une étape qui ne l’intéressait pas.
C’est la pire catégorie d’échec. Le rapport est rouge, mais le produit va bien. Il faut ouvrir les journaux, comprendre qu’on est tombé à l’étape 4 sur 12, et constater que rien de ce que le test devait vérifier n’a été atteint. Le temps perdu à diagnostiquer dépasse souvent le temps qu’on cherchait à économiser.
Plus grave encore : à force, l’équipe apprend que le rouge ne veut rien dire.
Le principe : séparer la mise en condition de la vérification
Le pattern tient en une phrase : mise en condition par l’API, vérification par l’interface.
Le test ne clique plus pour créer son contexte. Il l’obtient par des appels directs, en quelques secondes. Puis il ouvre l’application et vérifie uniquement ce qu’il est censé vérifier.
Ce n’est pas une astuce de contournement. C’est une remise au bon niveau : un test doit passer son temps sur son sujet. Tout le reste est de l’infrastructure, et l’infrastructure n’a pas à être jouée par un humain simulé.
Quand ne pas le faire
C’est la partie que les articles sur ce sujet oublient, et c’est elle qui décide si le pattern tient dans la durée.
Quand le parcours utilisateur est le sujet du test, on reste intégralement sur l’interface. Un test qui vérifie qu’on peut créer un dossier doit créer ce dossier en cliquant. Sinon il ne teste plus rien.
La règle que j’applique est simple à énoncer : si l’étape fait partie de ce que le test affirme, elle passe par l’interface. Si elle est seulement nécessaire pour que l’affirmation ait un sens, elle peut passer par l’API.
Conséquence directe : les deux modes doivent coexister. Il ne s’agit pas de migrer une suite de l’un vers l’autre, mais d’avoir les deux disponibles, et de choisir par test.
Ce que la mise en œuvre exige vraiment
Trois contraintes, et elles ne sont pas négociables. Sans elles, on obtient deux suites de tests au lieu d’une, et la maintenance double au lieu de baisser.
Un seul jeu de données de test. Les valeurs sont décrites une fois, au même endroit, indépendamment du chemin par lequel elles arrivent dans l’application. Le mode d’injection est un détail d’exécution, pas une propriété de la donnée. Si vous vous retrouvez avec un fichier de données pour l’API et un autre pour l’interface, ils divergeront avant la fin du mois.
Un seul jeu d’assertions. Ce qui est vérifié ne change pas selon le mode. Un test qui n’affirme pas la même chose dans les deux modes n’est plus le même test, et vous ne pouvez plus comparer leurs résultats.
Un interrupteur, pas une réécriture. Le basculement se fait par un paramètre au lancement. Le même fichier de test tourne dans les deux modes. C’est ce qui permet de vérifier, quand un doute apparaît, que l’écart de comportement vient bien du produit et non du raccourci.
Les pièges que j’ai rencontrés
L’API et l’interface ne produisent pas exactement le même état. Un champ calculé côté client, une valeur par défaut appliquée par le formulaire et pas par le service, et voilà deux contextes qui se ressemblent sans être identiques. Le test s’exécute alors sur un état qui n’existerait jamais en production, ou il échoue pour une raison sans rapport avec ce qu’il vérifie. Le seul remède est de comparer les deux états réellement obtenus, au lieu de supposer qu’ils coïncident.
Le mappage des données de test existantes vers ce qu’attend le point d’entrée. Les jeux de données sont écrits dans le vocabulaire du métier ; l’API attend sa propre structure, ses propres noms de champs, ses propres formats. Il faut donc une traduction entre les deux, et cette traduction est du code à maintenir. C’est le vrai coût d’entrée du pattern, et il est régulièrement sous-estimé : le gain ne commence qu’une fois cette couche écrite.
Savoir ce que chaque point d’entrée attend vraiment. Un champ oublié, ou au contraire un champ envoyé alors qu’il aurait dû rester vide, et le test travaille sur un contexte faux. Rien ne le signale : l’appel réussit, l’application affiche quelque chose, le test rend un verdict. C’est le piège le plus coûteux parce qu’il est silencieux, et un verdict faux vaut moins qu’une erreur franche.
Les résultats
Sur le périmètre concerné :
- Deux à trois fois plus rapide, pour chaque test basculé. La mise en condition passe de plusieurs dizaines de secondes à environ deux.
- Nettement moins de tests instables. Les échecs survenant dans des étapes qui n’étaient pas le sujet du test ont largement disparu, puisque ces étapes ne sont plus jouées.
- Le mode intégralement interface reste disponible, et sert quand il y a un doute sur un résultat obtenu par injection API.
Le gain de temps est celui qu’on met en avant. Ce n’est pourtant pas le plus important.
Le vrai bénéfice, c’est qu’un test en échec redevient une information. Quand un test ne traverse plus que ce qu’il vérifie, un rouge signifie quelque chose. Et un rapport qui signifie quelque chose se lit, au lieu d’être relancé.